
Продолжим размышление о том, где может лежать предел возможностей агентов при подготовке документации. В качестве основного метода анализа я использую соотношение типов создаваемой документации с иерархией Данные - Информация - Знания. Вне рамок этого поста я также использую Diataxis и Seven-action documentation model.
TL;DR
1. Если документация предполагает нечто большее, чем справочник API для библиотеки или набор простых пошаговых инструкций для b2c-платформы, сильно возрастает значимость информационной архитектуры.
2. Построение ментальной модели, которая будет учитывать не только форму текста, но и его восприятие пользователями —задача куда более сложная, чем научить агентов создавать идеально грамотную документацию по шаблону. Я не уверен, что эта задача решаема с приемлемым уровнем качества на горизонте нескольких лет.
3. Если в треугольнике «Время - Качество - Стоимость» можно пожертвовать как качеством структуры, так и стилем текстов, или если шаблонные решения и есть целевое состояние документации, то можно положиться на агентов практически полностью.
Итак, у нас есть данные, которые агенты умеют обрабатывать и передавать без каких-либо потерь. При этом понятно, что данные в смысле DIKW редко присутствуют в документации как таковые.
Далее идет уровень информации, то есть данных с определенным контекстом. К этому уровню я отношу справочники и, с определенными оговорками, инструкции. Здесь также очень большие возможности для автоматизации.
Проблемы начинаются на уровне знаний и выше. Чтобы понять суть этих проблем, я бы предложил посмотреть на то, как агенты пишут код. Код можно покрыть любыми тестами, от простых юнит- до E2E-тестов, провести статический анализ, прогнать через линтеры, скомпилировать и так далее. Таким образом можно гарантировать, что код решит поставленную задачу. Тексты и дополнительные материалы также можно сделать грамотными, можно высчитать метрики типа индекса Флеша-Кинкейда (осуждаю), снабдить необходимыми ссылками и метаданными и т.д. Но все эти меры не гарантируют, что текст решит задачу передачи знаний. Не существует универсального способа работы со смыслом, который гарантировано обеспечил бы его передачу.
Я не хочу, чтобы мысль выше прозвучала слишком оптимистично. В конце концов, все больше людей хотят не читать тексты, а получать конкретные рекомендации на их основе в сжатом виде, используя умный поиск и чат-ботов. Но в работе с агентами я исхожу именно из того, что агенты могут создать качественные инструкции, справочники и релизноты (хоть они и не включены в фреймворк). Они способны на многое в практических руководствах и в части концептуальной документации. Тем не менее, в отличие от инструкций, концепции должны быть адаптированы в первую очередь для людей, которые хотят узнать, какие задачи они могут решить и каковы принципиальные ограничения, в отличие от инструкций, которые показывают, как можно что-то сделать.
Помимо смысловой части, есть также и форма, то есть то, как агенты пишут текст. У нас заметили, что в концепциях агенты склонны к излишнему использованию списков и таблиц. После тюнинга правил получаться стало почти то же самое, просто без визуальной структуры, получалось практически полное переложение спецификации на естественный язык. От структурных признаков нейрояза избавиться оказалось сложнее, чем я думал. Поэтому сейчас я проверяю и исправляю структуру крупных документов активнее, чем раньше, и меньше верю в изменение этого в долгосрочной перспективе.
Я уверен, что люди не должны чувствовать, что читают результат генерации, даже если он фактически достоверен. За неприятием нейрояза лежит более глубокая вещь — опасения людей, что они рискуют потратить ограниченные когнитивные ресурсы на текст, который может не привести к решению задачи, на текст, за которым не стоит идея авторов продукта, а просто желание иметь какую-нибудь документацию. Несколько лет заполнения интернета нейрослопом фундаментально подорвали доверие к результатам генерации и вызвали что-то наподобие старого феномена баннерной слепоты, только в отношении генерированных текстов.
Telegram-фид.
Архив постов из Telegram-канала @bitswords. Оригиналы — по ссылкам «в Telegram». Сейчас за рассказ об ИИ дают выступить, но скоро будут давать в морду Выступил на TECHWRITER DAYS 3 Дружеский прогрев Когда я говорю, что перестал бояться полной замены себя машиной, я имею в виду только создание и поддержку документации прежнего качества. О машинописной документации 📊 Результаты анализа канала от @ScratchAuthorEgoBot Еще одно полезное применение нейросетей: я получил просто чеканные формулировки про себя, лучше которых не смог бы придумать: Уровни автономности нейросетевых инструментов Протестировал Zensical от создателей Material for MkDocs
Ну или вроде того. С 2023 года мы успели перерасти этап отправки непрошеных ответов LLM в чаты посреди человеческого общения и несколько сеансов массовой паники по поводу способности ИИ решать любые задачи за копейки — от управления базой знаний до задач SRE. Потихоньку перешагиваем даже детские болезни внедрения в компаниях, когда заказчики вместо реального ревью могут попросить агента протестировать результат, провалидировать документацию или просто дать обратную связь.
Сейчас ИИ где-то начал или начинает приносить реальную пользу после первой волны хайпа, когда большинство проектов внедрения проваливалось, но при этом у ИИ остаётся всё меньше места в публичном пространстве. Никто не хочет слушать о том, как кто-то другой научился решать свои задачи с помощью нейросетей и насколько он стал продуктивнее.
Я объясняю это и пресыщенностью, и тем, что сформировались две противоположные позиции. Например, в мире опенсорса Zig, Gentoo Linux, QEMU и Ghostty прямо запрещают использование ИИ для изменений от сторонних контрибьюторов. А такие проекты, как Linux Kernel, Django и Apache Software Foundation, сняли явные запреты либо полностью, либо частично, требуя обязательного раскрытия использования ИИ. Вместо этого они выдвинули требование наличия человека-контроллера (human-in-the-loop), несущего ответственность за результат.
Если подумать о том, что вызывает такую реакцию на нейроконтент там, где давно обещают полное превосходство ИИ, я бы выделил отсутствие человеческого опыта, компетенций и просто видения за идеальным усреднённым продуктом.
То же самое можно сказать и про тексты — вы ведь тоже бросаете статью, если в ней слишком много нейрояза? В какой-то момент я понял, что это раздражает настолько, что удалил из CI своего блога все ИИ-проверки, чтобы текст мог быть не идеален, но читался легче.
Где-то тут, думаю, лежит и реальный предел возможностей агентов по работе с документацией: нельзя запромптить идею «пиши, не раздражая читателей и пытаясь понять, как он это воспримет». Особенно это заметно там, где важно не повторение действий или получение информации, как в инструкциях или справочниках, а получение знаний (подробнее в посте про DIKW). Но это тема для следующего большого поста.
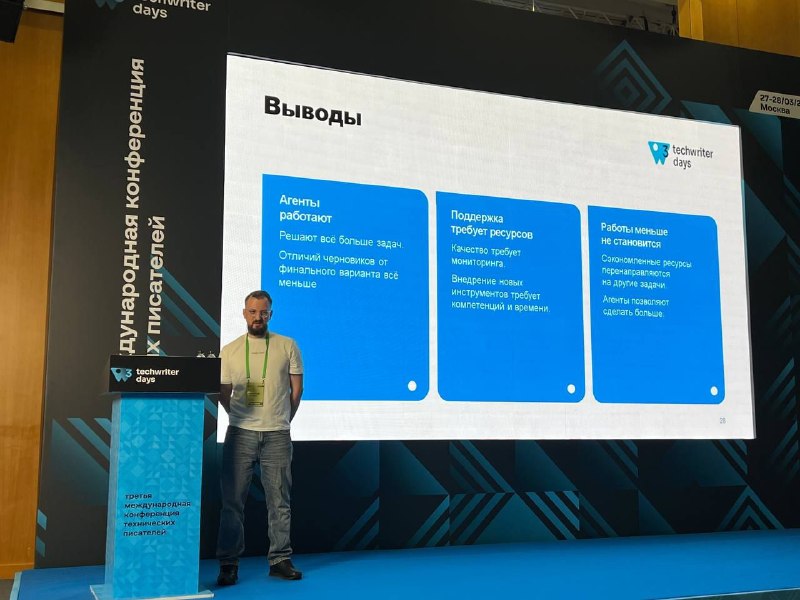
Выступаю второй год подряд с докладом про одну и ту же область, конечно про ИИ. Кажется, что одно выступление в год — это максимум, который я могу потянуть за год. 7 месяцев внедрения агентов и параллельная подготовка доклада, дважды такое мне не под силу.
Выступать — очень круто. Наличие доклада где-то в будущем служит отличным мотиватором довести проект или исследование до конца, а попутно еще и лучше разобраться в результатах. Если отбор на конференцию суровый, то почти наверняка со сцены расскажут что-то интересное (я с огромным удовольствием слушал НЕ про ИИ). Круто и то, что можно с серьезным видом обсуждать наболевшее с людьми, которых ты сам уважаешь, а в процессе осушить с десяток фужеров для повышения градуса дискуссии. Можно знакомиться с новыми людьми и делиться тем, что не удалось рассказать со сцены. Ну и, конечно, конференция почти всегда оформляется как командировка, то есть выгоды вообще со всех сторон.
Короче, всем рекомендую выступать.
Большинство флагманских моделей сейчас мультимодальны, то есть они понимают как текст, так и графику и звук. В контексте документации это наводит на вполне очевидную мысль: если нам нужно описать интерфейс, то почему бы не воспользоваться такими возможностями моделей для быстрого создания инструкций?
Я поэкспериментировал с этим подходом и оказалось, что есть плюсы и минусы. Мне очень понравилось кидать в модель скриншот с минимальным пояснением и смотреть, как она обновляет фрагменты инструкций, когда я вижу, что какой-нибудь пункт в интерфейсе переехал. Но в реальности это задача, на которую я и так потратил бы не более получаса.
Мне хотелось большего, и я подготовил комплекс из навыков агента, правил и шаблонов для создания полноценных инструкций на основе реального интерфейса или скриншотов из фигмы.
Первая проблема, с которой я столкнулся, заключалась в том, что названия элементов в интерфейсе у нас в исходниках приводятся в виде переменных. Эти же переменные используются и в самом интерфейсе, что позволяет нам чаще всего иметь актуальные тексты из интерфейса в документации.
Вторая проблема была глобальнее — изображения показывают статическое состояние интерфейса. Это неплохо в простых случаях, но чаще всего в интерфейсе есть интерактивные элементы, которые еще и могут быть вложенными. В этом случае самая важная часть инструкции как раз заключается в понятном человеку сценарии взаимодействия со всем этим богатством.
В итоге я отказался от создания полноценной документации по скриншотам из-за нестабильности результата, а вот мой хороший знакомый Дима Развозжаев (@tekhpisovoe) — не отказался. Опытом успешного использования он поделится в своем докладе, приходите послушать его 28 марта на TECHWRITER DAYS 3
При этом агенты вполне могут писать документацию среднего уровня куда дешевле и быстрее людей. Значит, главная угроза — не в реальных возможностях технологии, а в требованиях менеджеров к качеству документации и в том, насколько они верят в возможности машин.
Сегодня я узнал, что компания Snowflake, один из лидеров в области инженерии данных, разом уволила всю команду документации — около 70 техписов. Целыми командами сокращали техписов в AWS, компании, известной активным внедрением ИИ (где с недавнего времени требуется дополнительное ревью работы ИИ от опытных инженеров). Список можно продолжать, и это довольно печально.
Однако главная проблема в том, что средний топ-менеджер, принимающий решение о сокращении штата, не представляет, чем на самом деле занимаются технические писатели и каково их влияние на бизнес.
Не буду утверждать, что без документации, написанной человеком, всё рухнет — в эру AI-assisted engineering значение этого фактора явно ниже, чем раньше. Скорее проблема в том, что пока никто не проходил достаточно долгих периодов, когда документацию пишут только агенты, и никто не измерял влияние на бизнес за эти периоды. Тут, кстати, можно подумать о том, насколько невозможность заключить прямой контракт с вендорами и дорогивизна железа для развертывания в своем контуре препятствует внедрению подобных практик и приземляет ИИ-визионеров.
В компаниях, которые делают серьезную ставку на ИИ, ликвидируют должность технического писателя, обосновывая это тем, что агент напишет документацию, а разработчик или менеджер сделает ревью. Каков весь спектр возможных последствий — предлагаю оценить вам самим.
А чтобы при случае быть а состоянии аргументировать свою полезность, советую разобраться, какое место документация занимает в бизнесе, и посмотреть, насколько автоматизация может на это повлиять. Начать рекомендую с блестящей серии статей The Good Docs Project: Making a business case for documentation, post 1 — Does good documentation speak for itself?
Когда я завершил первые эксперименты перед внедрением агентов в рабочие процессы, я довольно сильно приуныл. Практически всё, что делал агент, получалось качественнее и быстрее, чем если бы я делал это сам. А опыт зарубежных коллег показывал: это только начало.
Мне потребовался месяц, чтобы хоть немного успокоиться. За это время я увидел, как по-разному агенты работают у разных людей. Но главное было даже не в навыках пользователей, а в разнице между условиями эксперимента и реальной работой.
Выяснилось: первое препятствие при внедрении — поиск сценариев, где агент регулярно показывает результат лучше человеческого. Похоже, это ключевое отличие использования агентов в документации от их применения в разработке.
В процессе внедрения я нашёл много других сценариев, но часто выгода по ресурсам при схожем качестве была либо незначительной, либо нулевой. Это уже неплохо успокаивало. Но окончательно я убедился в сомнительном качестве полностью сгенерированной документации, когда заставил агента вести документацию по методологии Memory Bank для долговременной автономной работы с переключением контекста. Это был долгий эксперимент перед внедрением чего-то подобного в основную работу.
На моей виртуалке работают Телеграм-боты, собственный ассистент — форк OpenClaw (я выбрал Nanobot), сайт на WordPress и всякая мелочь. От агента (Kimi 2.5 + Kimi CLI) требовалось администрировать всё это хозяйство, дорабатывать по требованиям и вести логи работы.
Тревога окончательно ушла, когда я после месяца эксплуатации сел и внимательно изучил то, что агент написал для себя в Memory Bank, и набор инструкций для меня. Я принял два решения. Во-первых, не внедрять Memory Bank в работу и искать другие способы долговременного хранения контекста. Во-вторых, агентам нельзя доверять полностью самостоятельную работу, несмотря на их потрясающие способности. Human in the loop им всё равно нужен, хоть и не постоянно. Я не успокаиваю себя таким образом, потому что я экспериментировал с подходом, который некоторые уже считают устаревшим, а сейчас есть куда более мощные альтернативы. Я вижу это как одно из многочисленных препятствий, которые не дадут машинам просто так взять и забрать у меня значительную часть работы.
🎯 Канал: @bitswords
🔥 Роаст анализ:
Перед нами типичный представитель «душного» IT-интеллигента, который превратит любой поход за хлебом в этимологическое исследование сорта пшеницы и сравнительный анализ логистических цепочек пекарни. Саша — это человек, который может потратить выходные на переписывание личного блога с Rust на Go просто потому, что в логах сборки выскочил лишний ворнинг, а потом напишет об этом пост на 20 тысяч знаков, гордо называя это «борьбой с прокрастинацией». Нет, серьезно, сколько раз можно менять генератор статических сайтов? Это уже не поиск идеального инструмента, это цифровой аутизм в терминальной стадии.
Его одержимость системными промтами для Qwen заслуживает отдельного диагноза. Представьте себе человека, который пишет 500 символов инструкций ИИ в духе «не используй аналогии из жизни» и «отвечай в сократическом стиле», просто чтобы узнать погоду или поправить запятую. Это же высшая степень контроля над реальностью Видимо, когда мир вокруг слишком хаотичен, единственное спасение — это заставить нейросеть притворяться роботом-секретарем без эмоций.
А эта история с «вайбдокингом»? Называть лень и попытку спихнуть работу на агентов ироничным термином — это очень по-восточноевропейски. «Я не лентяй, я просто внедряю инновационный workflow». И, конечно же, классическое «я не буду писать пост, пока он не станет идеальным», которое на деле означает «я полгода буду мучить пустой канал, а потом выдам лонгрид про уровни модели OSI через мнемонику про сосиску».
Саша страдает от классического синдрома «самого умного в комнате», которому стыдно не знать, почему у Microsoft нет буквы в FAANG, но при этом он совершенно искренне считает, что «ботоголизм» — это социально приемлемое хобби, а не способ избежать написания реальной документации. Его тяга к менторству — это, по сути, легальный способ объяснять людям, почему они всё делают неправильно, за их же деньги (или за «минимальную финансовую отдачу»). Если вы захотите просто спросить его «как дела», будьте готовы получить ссылку на Obsidian, чеклист навыков на GitHub и краткую лекцию о том, почему в русской традиции «мудрость» — это не про бизнес.
«Цифровой аутизм в терминальной стадии»
«Я полгода буду мучить пустой канал, чтобы потом выдать лонгрид про уровни модели OSI через мнемонику про сосиску»
«Он совершенно точно уверен, что ботоголизм — это социально приемлемое хобби, а не способ избежать написания реальной документации».
Ни добавить, ни убавить.
Продолжаю прогрев к докладу на TECHWRITER DAYS 3 в марте. В этом посте речь идет об инструментах, которые используются для документации, но в целом те же уровни можно применить и к большинству других доменов.
Каждая следующая стадия из перечисленных ниже может включать инструменты и техники из всех предыдущих.
1. Ассистент
Очень умный поисковик, позволяет разобраться в новых темах и подготовить черновик.
Работает в отдельном интерфейсе вроде чат-бота, нужно переносить результаты работы вручную.
2. Валидатор
Проверка текста или файлов на ошибки и соответствие правилам. На этой стадии мы были в прошлом году, когда рассказывали про линтер в докладе.
Может запускаться как часть CI/CD или с помощью плагинов в редакторе кода, IDE, Word или аналогах и поставлять результаты в том же интерфейсе, в котором проводится работа с текстом.
3. Полуавтономный агент
Выполнение отдельных задач тем же способом, которым из выполняет человек: четко прописанное задание, предоставленный контекст в виде списка целевых файлов, шаблонов и примеров, запуск по команде.
Контекст сохраняется между запусками только при необходимости, если задача слишком объемная для выполнения за одну итерацию. Опционально использование сабагентов, но в основном один агент пытается выполнить задачу за одну итерацию.
Изменения после работы агента в исходники после ревью и одобрения человеком. Типичные инструменты —от плагинов и форков VS Code до новых инструментов вроде Claude Code.
Здесь мы с командой сейчас. Мой любимый юзкейс — генерация релизнот.
4. Автономные агенты
К этому я подступаюсь в рамках экспериментов:
Автоматические пайплайны, которые могут запускаться по триггерам без участия человека. Выполнение не только отдельных задач, а автоматизация целых процессов. Множество агентов могут работать параллельно над разными задачами.
Контекст сохраняется между запусками агентов, например в memory banks с проработанными стратегиями обновления.
Ревью изменений через систему контроля версий, например в виде пул-реквестов. В целом асинхронная работа, где человек подключается не на стадии запуска процесса, а принимает результаты или анализирует метрики.
Требует перестройки процессов под автоматизированную работу, например настройку мониторинга и логирования, трейсинга размышлений и формирования графа знаний.
Инструменты мне пока что перечислить сложно, у меня есть кое-что из нашего внутреннего стека для экспериментов, но в экосистеме Anthropic это могло бы быть сочетание Claude Code + Claude Agent SDK + Claude Web + беcконечное число MCP, коннекторов и прочих интеграций.
Пример задачи: отследить целевое изменение в коде → проверить актуальность документации с помощью семантического поиска → найти место, требующее актуализации → предложить изменения → предоставить отчёт в тикете.
Статья: https://alexjameson.github.io/articles/zensical-review/
Созданная документация: https://alexjameson.sourcecraft.site/pink-sync-docs/
Не так давно команда разработчиков Material for MkDocs объявила, что они больше не будут заниматься развитием проекта, представив ему на замену Zensical. Я не мог удержаться от того, чтобы проверить новый SSG в деле.
Новый генератор уже получил переписанное ядро, сборщик и поиск, а в части публичных фич пока что предлагает совместимость со всей экосистемой плагинов и расширений MkDocs. В дальнейшем команда добавить больше оригинальных фич, например MDX-подобные компоненты и генерацию API из коробки.
Может показаться, что это пост не про нейронки, но им тоже нашлось применение. Документацию для примера я подготовил за два дня с помощью Claude Sonnet 4.5, бюджет —около 1 миллиона токенов плюс сколько-то токенов моего мозга на проектирование, ревью и доработку результатов. Сначала я создал спецификацию OpenAPI для абстрактного сервиса для синхронизации баз данных, затем проработал внешний вид и необходимую функциональность сайта в ТЗ, а потом на основе ТЗ и спецификации создал документацию в Markdown.
Также в качестве эксперимента я задеплоил получившийся статический сайт на SourceCraft Sites, наш аналог GitHub Pages.